(文/赖家琪 编辑/吕栋)
在美国人工智能(AI)企业专注价格昂贵的闭源模型之际,DeepSeek将自己的技术“家底”向外界开放,赢得海外网友称赞。
10月20日,DeepSeek宣布开源内部生产级推理框架DeepInfer。
该框架是DeepSeek在面临美国尖端芯片出口限制下,确保大模型紧追美国顶尖AI模型的核心。推理框架负责管理模型如何使用计算资源来处理用户请求,其设计会影响延迟、吞吐量以及运行模型所需的硬件,因此是影响AI运营成本的重要因素。
美国彭博社21日指出,推理技术通常被AI公司视为核心竞争力,较少对外公开,而DeepSeek此次公开推理框架,让外界得以一窥其是如何在压低运行成本的同时,确保AI模型性能的。
即使是同一款AI模型,实际运行成本也可能因所采用的软件不同而存在较大差异。更加高效的软件能够降低每次请求所需的计算资源,并有望进一步减少能源消耗。
DeepInfer整合了分布式推理、投机解码等多项技术,能够让AI工作负载分配到不同硬件上,从而让模型在更短时间内生成更多输出,并进一步挖掘芯片的性能。目前,该框架已兼容英伟达SM100 GPU和华为昇腾950 NPU。
这其中不少的底层技术已被业界广泛采用,但DeepSeek针对自身模型进行了专门的优化,使这些技术能够更加高效地协同运行。
美媒称,对于AI托管服务商而言,更低的推理成本意味着更大的利润空间,并有可能进一步转化为更低的AI服务价格。对于企业用户来说,如果选择在自有基础设施上运行DeepSeek模型,DeepInfer也可能帮助其降低算力成本。
不仅如此,DeepSeek开源DeepInfer后,其他开发者也可以研究其中的技术方案,并将部分方法应用到自己的模型推理系统中。
在DeepSeek宣布开源DeepInfer的帖子下方,美国加州一家专注于大语言模型与AI开源优化、本地训练和推理的公司Unsloth AI公开感谢DeepSeek称,其已经借助Dynamic GGUFs,让DeepSeek-V4.1-Flash-1017能够在配备128GB内存的设备上实现本地运行。
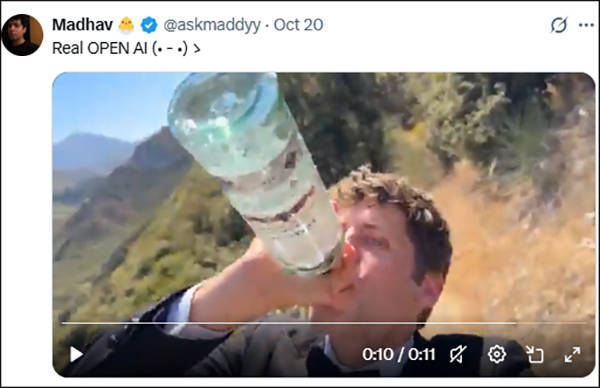
评论区还出现了大量海外开发者和AI从业者的积极反馈。一名来自印度的社交媒体博主直接用“Real OPEN AI”(真正的开放AI)评价DeepSeek,并配上一段调侃OpenAI首席执行官山姆·奥尔特曼的视频。
欧洲AI从业者也用漫画嘲讽美国AI公司的闭源模型仅限特定“朋友圈”,与之相对的是中国公司通过降低成本,让AI模型更普惠。
一名来自孟加拉国的软件开发者赞叹说,DeepSeek可能是对开源大语言模型生态贡献最大的公司之一。
当然,DeepSeek此次发布的并不是一套完整的推理技术栈。其文档提到,要构建完整的服务,还需要KV缓存系统、Prefill/Decode解耦,以及在数据并行副本之间进行负载均衡等功能,这些内容并未完全包含在此次开源项目中。不过,大部分核心的解耦功能已经实现。
AI基础设施初创公司Requesty首席执行官蒂博·杰古(Thibault Jaigu)表示,DeepInfer降低了部署DeepSeek模型的门槛,但企业仍需要具备相应的算力和技术能力。他认为,DeepSeek实际上是在告诉外界,“任何人都可以自行托管我们的模型,不过要实现高效的管理,还是有一些技巧需要注意”。
在广大海外网友看来,DeepSeek所做的已不仅仅是发布一个开源推理框架,而是它正在把越来越多原本属于企业内部的技术公开出来,让更多人能够参与进来。这与美国AI行业越来越强调闭源模型、庞大的算力投入和商业护城河的路线形成鲜明对比。
OpenAI的名字里虽然带着“开放”,但其核心模型长期采取闭源策略,反倒是来自中国的DeepSeek正用实际行动践行“开放”一词。
“为善与众行之,为巧与众能之。”正如DeepSeek所说,“我们期待着在不远的未来,能够看到全球AI服务的范围与质量获得前所未有的扩展与提升,变得更加公平、透明、可信赖,进而实现在全社会范围内加快技术迭代、减少能源浪费。”


 京公网安备 11011402013531号