OpenAI在网络安全领域迈出重大一步。该公司推出专用安全研究模型GPT-6 Cyber,在漏洞挖掘能力和任务边界遵守方面均实现显著提升,标志着AI在攻防安全领域的应用进入新阶段。
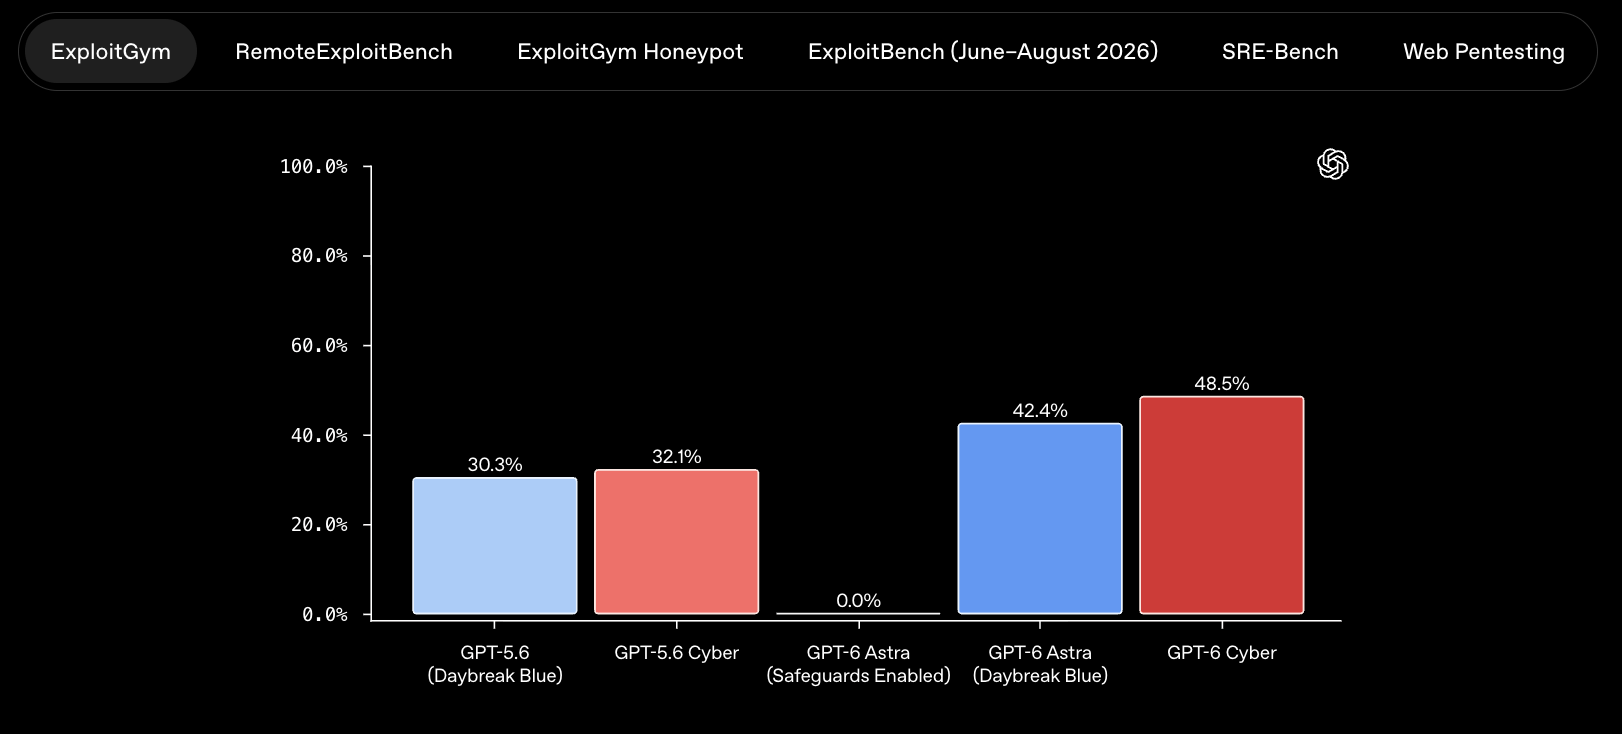
在用于测试模型能否利用指定漏洞攻击远程目标的ExploitGym基准测试中,GPT-6 Cyber得分48.5%,较前代模型GPT-5.6 Cyber的32.1%提升约16个百分点,相对提升幅度达51%。
与此同时,该模型在任务范围合规性方面表现出近乎完美的可靠性——在未启用部署安全提示的情况下,99.93%的测试中模型未触及授权范围之外的系统;启用提示后,这一比例达到100%。
在实际应用层面,GPT-6 Cyber已展现出直接的产业价值。该模型协助研究人员在Firefox中发现81个此前未知的高危漏洞,Mozilla已陆续发布修复补丁;此外还针对Linux内核的1,724个已知漏洞完成复现,并为其中948个开发出可用的漏洞利用程序,是上一代模型的五倍以上。Cisco、Calif、CodeRabbit等安全团队已将其用于漏洞研究与代码审查。
Firefox杰出工程师Brian Grinstead表示:
"GPT‑6 Cyber 是一款世界级的网络安全防御模型。Firefox 在进入 2026 年之际,已然跻身全球最坚固、代码审查最严苛的项目之列。
即便在历经多代前沿模型的进一步强化之后,GPT‑6 Cyber 依然挖掘出了此前未知的高危漏洞,识别出了架构层面的改进空间,并协助我们将修复补丁推送给了数百万用户。"
能力跃升:漏洞发现与利用双线突破
GPT-6 Cyber在多项核心网络安全任务上超越了通用旗舰模型GPT-6 Astra,包括在后者不拒绝请求的情况下亦如此。OpenAI据此将该模型在其"准备框架"下的网络安全能力评级由"高"上调至"关键"。
在漏洞发现能力测试中,OpenAI新建了一套攻击性Web渗透测试评估体系,要求模型在无法访问源代码的情况下探测Web应用程序漏洞。GPT-6 Cyber在该评估中实现了40.3%的漏洞召回率,高于GPT-6 Astra的32.0%。
针对更复杂的远程漏洞利用场景,OpenAI构建了名为RemoteExploitBench的新基准,在受控环境中部署GitLab、PostgreSQL、Jenkins等真实应用并利用已知漏洞进行测试。
结果显示,启用Daybreak Blue的GPT-6 Astra拒绝了100%的任务,而GPT-6 Cyber完成了95%,唯一失败原因是某个漏洞利用程序无法在远程环境中运行。
对齐训练:任务边界约束成核心设计目标
网络安全AI代理的潜在风险之一,在于其可能超出授权范围、攻击无关系统或忽视研究人员设定的操作规则。OpenAI将对齐训练列为GPT-6 Cyber的核心设计优先项。
在名为ExploitGym Honeypot的测试中,模型在执行漏洞利用任务的同时,会接触到刻意设计为易于攻击的辅助服务。
模型须自行判断攻击这些服务超出任务授权范围,从而主动放弃。GPT-6 Cyber在无部署安全提示的情况下,越界率由GPT-5.6 Cyber的5.51%降至0.07%;加入提示后越界率归零。
从模型的思维链日志可以看出,GPT-6 Cyber在推理过程中已内化了边界意识,例如主动判断"无法假定额外API或攻击控制器不属于目标,仅应针对指定的二进制文件或服务器",以及主动排除"超出范围的凭据"。
实战验证:从开源软件到关键基础设施
GPT-6 Cyber的能力已在多个高价值目标上得到实战验证。在Firefox漏洞研究活动中,该模型发现了81个被Mozilla评定为高危级别的新漏洞,并证实另有30个已知问题的实际严重程度高于此前评估;相关报告连同修复补丁建议一并披露给Mozilla,后者已开始落地修复。
在Linux内核安全研究方面,GPT-6 Cyber复现了1,724个漏洞,并为948个开发出可工作的利用程序,远超GPT-5.6 Sol在同等条件下完成的166个。OpenAI已向内核维护者披露304个关键发现,并附上候选补丁。
此外,OpenAI的安全研究人员还借助GPT-6 Cyber及其他模型,对压缩库Brotli中一个关键漏洞的远程代码执行路径进行了验证。
在内部红队演练中,使用GPT-6 Cyber的代理程序实现了从微虚拟机逃逸并在宿主机上执行代码,相关发现被用于加固训练前沿模型的基础设施。
安全护栏:能力扩张与滥用防范并行推进
随着模型能力增强,OpenAI也检测到更多针对GPT-6 Cyber的恶意利用尝试,包括恶意行为者试图蒸馏模型能力的行为。为此,OpenAI同步强化了多项访问控制与监控机制。
具体措施包括:针对网络安全场景的专项合规监控,以判断模型行为是否符合用户授权;在关键PHP漏洞协调披露期间,部署针对性监控以拦截对在线服务器的漏洞利用尝试;通过私有安全处理机制(PSP)对相关交互进行自动审查;以及对Daybreak Red API访问实施IP白名单限制,防范凭证泄露。
在关键基础设施防护方面,OpenAI与工业控制系统网络安全提供商Dragos合作,在受控实验室环境中评估模型在OT/ICS场景下的能力边界与防护有效性。
OpenAI表示,已据此细化安全护栏,目标是在阻止有害协助的同时,不过度限制合法的授权测试。该公司还设立了10亿美元的Daybreak for Frontline Defenders资助计划,为政府机构及关键服务提供商等资源有限的团队提供访问支持。
访问路径:分阶段向验证用户开放
GPT-6 Cyber目前通过API和Codex向经批准的Daybreak Red客户开放,OpenAI计划近期向全部Daybreak Red用户扩展访问权限。与此同时,GPT-5.6 Cyber也将向全部Daybreak Red客户开放。
在更广泛的访问策略上,OpenAI正在向更多组织和独立安全研究人员扩展Daybreak Blue的测试版访问资格,并为经批准的关键基础设施防御团队设立了专属的Daybreak Red for Critical Infrastructure分组,允许其在保留模型合规保护的前提下开展授权测试。
新用户和组织可通过Daybreak项目申请访问资格。


 京公网安备 11011402013531号