

对大模型有一定了解的人,都知道“规模化法则”(Scaling Law)。今天举行的2026世界顶尖科学家论坛·主论坛上,清华大学教授、智谱AI联合创始人唐杰在演讲中表示,应该用“规模化正确性”取代“规模化法则”,探索一门关于模型规模缩放的科学。在他看来,追求“规模化正确性”之路,可以让大模型具备越来越强的复杂任务自主完成能力,最终通向AGI(通用人工智能)。
今年10月发布的2026胡润百富榜,唐杰榜上有名,身家约275亿元,被一些媒体称为中国“首富教授”。他不仅创立了上市公司智谱AI,也是智谱AI首席执行官张鹏、月之暗面创始人杨植麟的导师,培养了一批人工智能领域的青年才俊。

唐杰教授在2026世界顶尖科学家论坛上演讲。
对于人工智能未来研发方向,这位清华教授有什么洞见?他提出了“规模化正确性”概念,向“规模化法则”发起挑战。2022年11月ChatGPT上线以来,遵循“规模化法则”的大模型研发进展神速。这个法则是一条经验规律,意思是在其他条件不构成瓶颈时,模型预训练的测试损失和参数量、训练数据量、训练算力三者各自满足幂律关系,参数、算力、数据同步放大,预测损失会平滑地持续下降,模型能力随之提升。这意味着,模型的参数量越大、训练算力越大、训练数据越多,模型的智能水平就越高。
然而,在唐杰看来,“规模化法则”只拟合训练损失,不能保证真实任务的正确性;训练损失下降,不等于推理可靠、代码可运行、长任务无幻觉。一味地遵循这个法则,其实是一条偷懒路径,应该建立一套回答“规模放大后,结论还能不能成立”的系统性方法论。他称之为“规模化正确性”,并把这条研究路线概括为:从“规模化法则”走向一门关于规模缩放的科学。
这条研究路线的提出,可谓恰逢其时:对话大模型升级为智能体后,训练试错成本大幅增长。前沿大模型的单次训练需要巨额投入,如果一个算法小规模能跑通,应用于大模型却失效,全部算力和时间将付诸东流。另一方面,AI处理的真实任务的复杂性越来越高,远超任何单一benchmark(基准测试)能囊括的范围。在此背景下,只在小规模条件下成立的结论,规模放大后往往不再有效。
规模化失效并非单一问题,而是分布在优化与超参数、模型架构、数值精度、并行与系统工程、数据、后训练等6个维度上,任何一个维度的失效都可能导致整个项目翻车。因此,“规模化正确性”是横跨算法、芯片集群、数据与后训练全链路的系统性问题,不取决于单一指标。

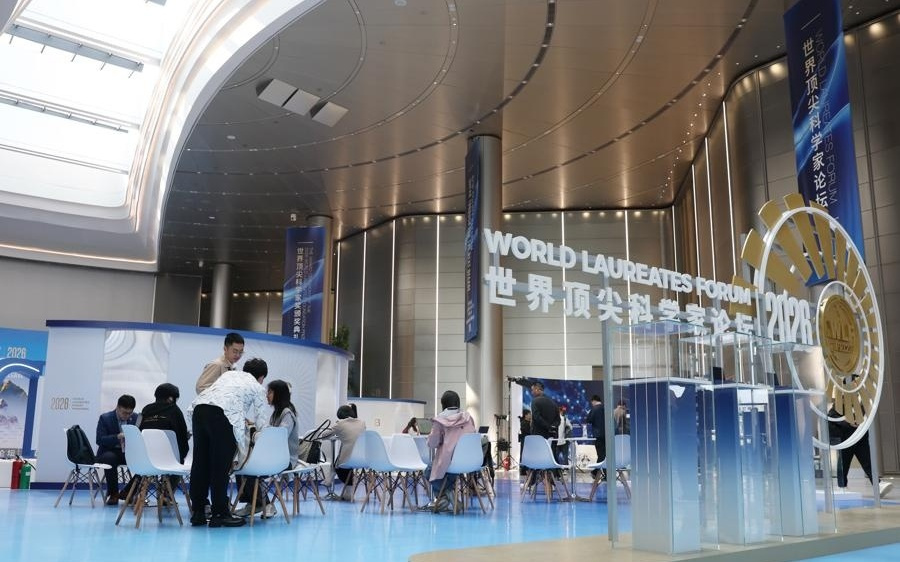
2026世界顶尖科学家论坛在上海临港中心举行。
唐杰指出,追求“规模化正确性”的核心方法论革新,在于改变评价单元。旧的大模型研发和评价范式是“任务驱动、单点对比”,即针对不同任务分别训练模型,只看各自的单点SOTA(某一领域的最先进水平),其结论很可能脱离规模、无法外推。新范式则是“缩放范式、曲线对比”,即以训练损失为坐标纵轴、算力、参数、数据量为坐标横轴,构建一条规模缩放曲线,其目标是通过小规模拟合,准确预测大规模(万亿参数级别)模型的表现。
这一新范式对方兴未艾的“递归式自我改进”(RSI)有重要意义。“递归式自我改进”是指人工智能系统以自身改进结果作为输入,不断优化自身能力并修改自身架构,形成自我改进闭环的过程,被业界普遍认为是实现通用人工智能的关键路径。唐杰认为,递归式自我改进能不能跑通,不取决于模型能否生成下一步,而是取决于它能否准确判断这一步是不是“进步”。
这种内化的评判能力,他称之为“自净化”。大模型只有具备“自净化”能力,才可以自主迭代、自我改进,最终实现新的智能突破。
原标题:《“首富教授”唐杰在顶科论坛演讲:用AI规模化正确性取代规模化法则》


 京公网安备 11011402013531号